Infraestrutura de IA Local de Alta Performance
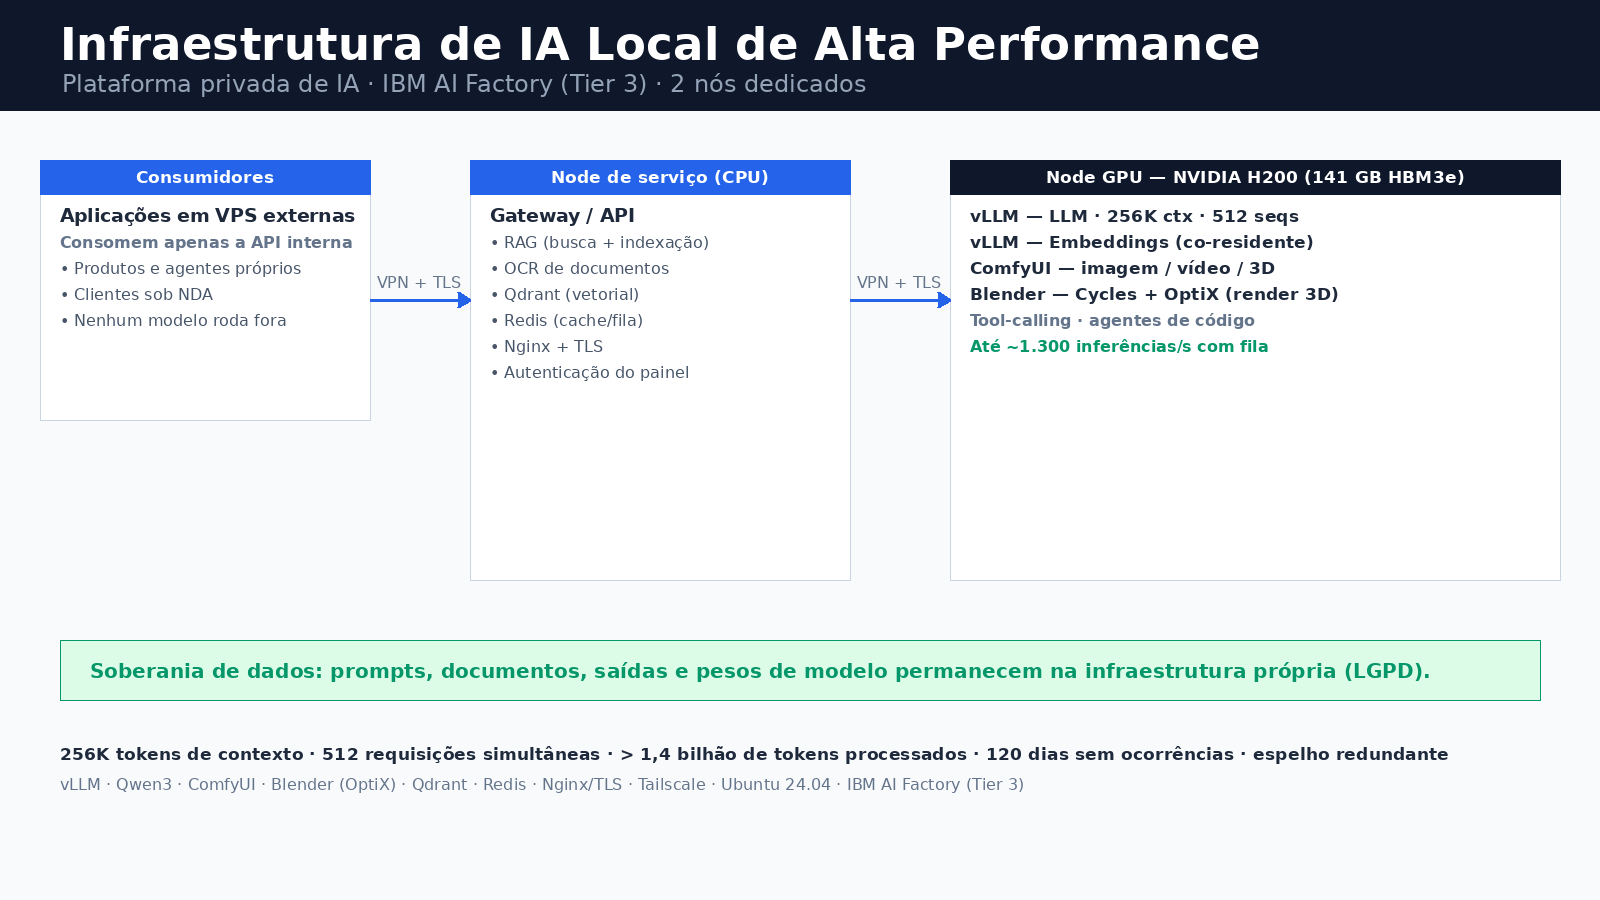
Plataforma de IA privada on-premise construída sobre 2 servidores dedicados, em parceria com a IBM AI Factory (datacenter Tier 3), para projetos que exigem estabilidade, segurança, governança e escalabilidade. Reúne, sob a mesma GPU, inferência de LLM, embeddings, RAG/OCR, geração de imagem/vídeo/3D e renderização 3D — servindo aplicações externas apenas por uma API interna compatível com OpenAI.
O que a plataforma entrega
- LLM de alta performance: contexto de 256K tokens, 512 sequências concorrentes e até ~1.300 inferências por segundo com fila de espera — pronto para cargas agênticas paralelas.
- Embeddings co-residentes na mesma GPU, para busca semântica e RAG.
- RAG e OCR (indexação documental) em node dedicado, com Qdrant e Redis.
- Geração de imagem, vídeo e 3D (ComfyUI) e renderização 3D com Blender (Cycles + OptiX) na GPU.
- API compatível com OpenAI: qualquer SDK ou cliente existente funciona sem mudança de código.
Arquitetura
Dois nós complementares: um node GPU dedicado à inferência pesada e um node de serviço (gateway, RAG, OCR, busca vetorial e proxy TLS). A comunicação entre nós e consumidores usa VPN mesh e túnel reverso com chave dedicada; o acesso é protegido por Nginx + TLS e autenticação no painel.
As aplicações consumidoras ficam em VPS externas e consomem apenas a API interna — nenhum modelo roda fora da infraestrutura própria.
Soberania de dados e segurança
- Os dados nunca saem da infraestrutura física: prompts, documentos indexados (RAG), saídas e pesos de modelo permanecem no ambiente próprio; nada é enviado a provedores de terceiros nem usado para treinar modelos de terceiros.
- Residência e conformidade: atende requisitos de LGPD e de clientes que proíbem o envio de dados sensíveis para a nuvem de terceiros.
- Controle total de retenção e descarte: excluir dados é excluir local, imediata e verificavelmente.
- Sem lock-in: API compatível com OpenAI e biblioteca de modelos local — trocar de modelo não quebra as aplicações.
- Auditoria: logs de inferência por serviço e banco de métricas próprio, rastreáveis no próprio ambiente.
Custo: tokens a custo marginal quase zero
Já foram processados mais de 1,4 bilhão de tokens — mais de 28 mil requisições de LLM e 58 mil de embeddings — sem qualquer cobrança por token. O custo é elétrico e de hardware já amortizado: custo marginal de inferência ≈ 0, sem throttling, sem fair-use e sem limite de requisições. Em APIs comerciais de classe equivalente, esse volume ficaria na casa de milhares de dólares — aqui, o custo adicional é indistinguível do consumo elétrico do servidor.
Método: pesquisa, laboratório e base documental
Nada aqui foi montado no improviso. A plataforma é resultado de pesquisa aplicada e experimentação em laboratório: comparação de vários modelos, teste de diferentes configurações de inferência e validação de desempenho antes de levar qualquer coisa para produção.
Essa base combina mais de 29 anos de experiência em desenvolvimento e arquitetura de software com leitura sistemática de documentação técnica oficial — OpenAI, Anthropic, Qwen e outras — e das informações de configuração e model cards publicados no Hugging Face. Cada parâmetro (contexto, concorrência, particionamento de VRAM, quantização, parsers) foi escolhido com base em evidência, não em suposição.
É essa combinação — experiência de engenharia somada a pesquisa e disciplina de laboratório aplicadas à IA — que permite extrair da GPU o melhor desempenho com estabilidade e previsibilidade.
Engenharia e operação
- LLM afinado em produção: decodificação especulativa (MTP), tool-calling nativo para agentes de código, particionamento de VRAM (LLM + embeddings na mesma GPU) e histórico de configurações mantido como scripts, permitindo troca sem reimplementação.
- Operação madura: serviços sob systemd com auto-restart, scripts de orquestração e health-check, runbooks e procedimento de rollback.
- Dashboard de operações próprio: status, métricas históricas, controle de start/stop e monitor de VRAM.
- Multi-tenant na GPU: protocolo documentado para o render 3D compartilhar e liberar a GPU com o LLM — uma única GPU atendendo inferência, geração de mídia e render simultaneamente.
- Estabilidade comprovada: 120 dias no ar sem ocorrências, com espelho redundante.
Em resumo: uma fundação de IA privada que transforma hardware dedicado em capacidade de inferência escalável, soberana e de custo previsível para produtos que exigem governança de dados.