Infraestructura de IA Local de Alto Rendimiento
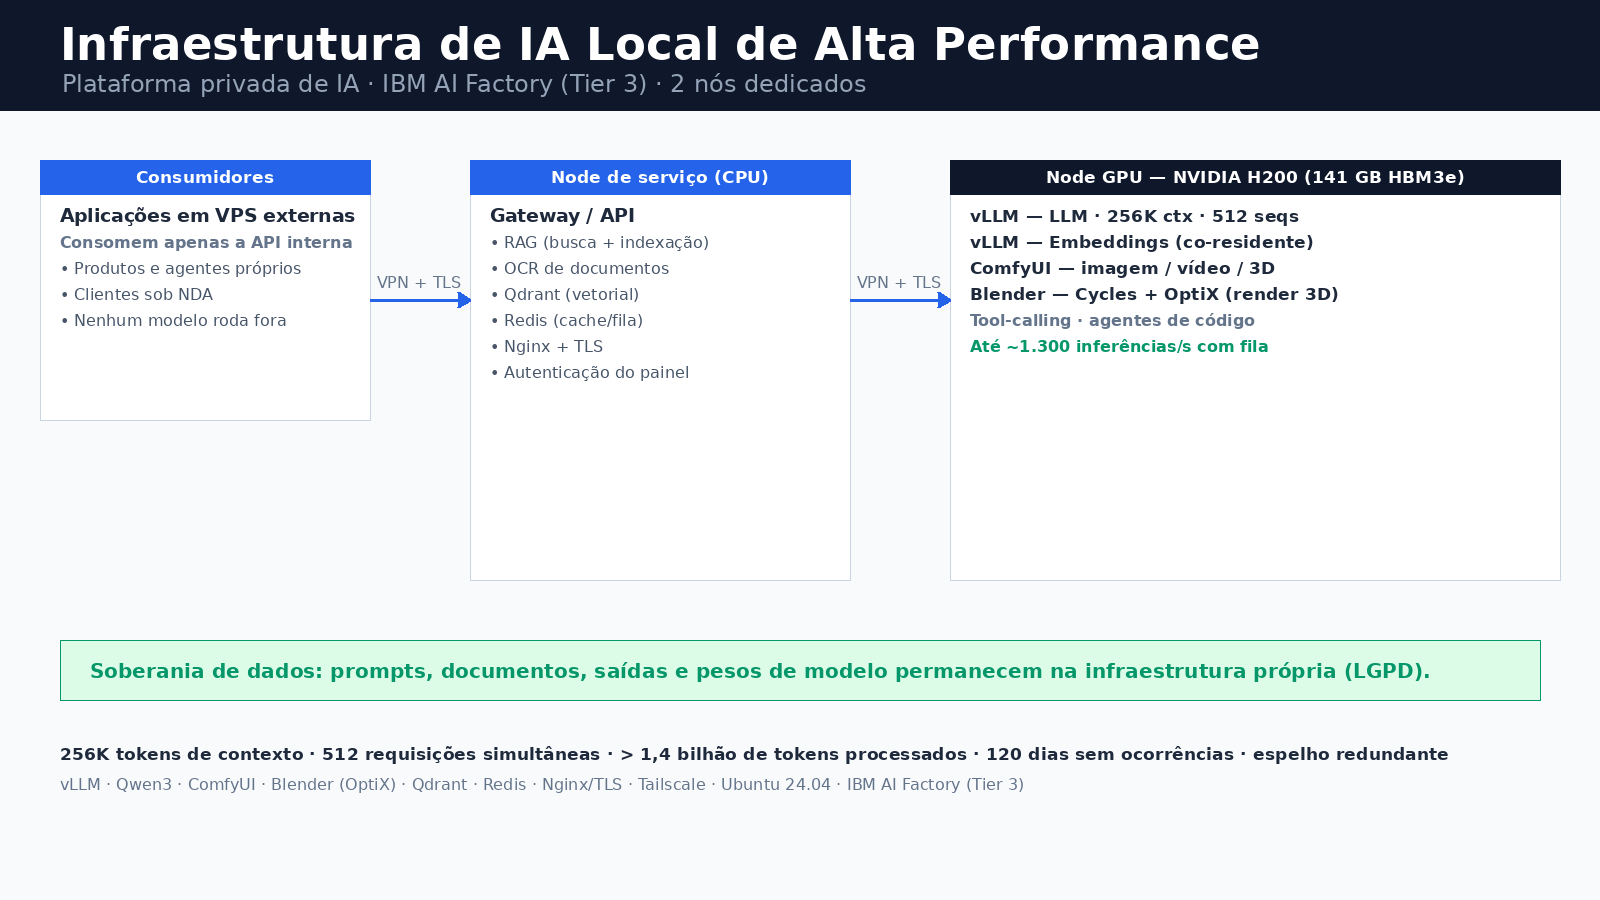
Plataforma de IA privada on-premise construida sobre 2 servidores dedicados, en alianza con IBM AI Factory (centro de datos Tier 3), para proyectos que exigen estabilidad, seguridad, gobernanza y escalabilidad. Reúne, en la misma GPU, inferencia de LLM, embeddings, RAG/OCR, generación de imagen/vídeo/3D y renderizado 3D — sirviendo aplicaciones externas únicamente mediante una API interna compatible con OpenAI.
Lo que entrega la plataforma
- LLM de alto rendimiento: contexto de 256K tokens, 512 secuencias concurrentes y hasta ~1.300 inferencias por segundo con cola de espera — listo para cargas agénticas paralelas.
- Embeddings co-residentes en la misma GPU, para búsqueda semántica y RAG.
- RAG y OCR (indexación documental) en un nodo dedicado, con Qdrant y Redis.
- Generación de imagen, vídeo y 3D (ComfyUI) y renderizado 3D con Blender (Cycles + OptiX) en la GPU.
- API compatible con OpenAI: cualquier SDK o cliente existente funciona sin cambiar el código.
Arquitectura
Dos nodos complementarios: un nodo GPU dedicado a la inferencia pesada y un nodo de servicio (pasarela, RAG, OCR, búsqueda vectorial y proxy TLS). La comunicación entre nodos y consumidores usa VPN mesh y un túnel inverso con clave dedicada; el acceso está protegido por Nginx + TLS y autenticación del panel.
Las aplicaciones consumidoras se ejecutan en VPS externas y usan solo la API interna — ningún modelo se ejecuta fuera de la infraestructura propia.
Soberanía de datos y seguridad
- Los datos nunca salen de la infraestructura física: prompts, documentos indexados (RAG), salidas y pesos de los modelos permanecen en el entorno propio; nada se envía a proveedores externos ni se usa para entrenar modelos de terceros.
- Residencia y cumplimiento: cumple requisitos de la LGPD y de clientes que prohíben enviar datos sensibles a la nube de terceros.
- Control total de retención y borrado: borrar datos es borrarlos local, inmediata y verificablemente.
- Sin lock-in: API compatible con OpenAI y biblioteca de modelos local — cambiar de modelo no rompe las aplicaciones.
- Auditoría: registros de inferencia por servicio y base de métricas propia, rastreables en el propio entorno.
Costo: tokens a costo marginal casi nulo
Ya se procesaron más de 1,4 mil millones de tokens — más de 28 mil solicitudes de LLM y 58 mil de embeddings — sin ningún cobro por token. El costo es eléctrico y de hardware ya amortizado: costo marginal de inferencia ≈ 0, sin throttling, sin fair-use y sin límite de solicitudes. En APIs comerciales de clase equivalente, este volumen costaría miles de dólares — aquí, el costo adicional es indistinguible del consumo eléctrico del servidor.
Método: investigación, laboratorio y base documental
Nada aquí se improvisó. La plataforma es el resultado de investigación aplicada y experimentación en laboratorio: comparación de varios modelos, prueba de distintas configuraciones de inferencia y validación de rendimiento antes de llevar cualquier cosa a producción.
Esta base combina más de 29 años de experiencia en desarrollo y arquitectura de software con la lectura sistemática de documentación técnica oficial — OpenAI, Anthropic, Qwen y otras — y de las informaciones de configuración y model cards publicadas en Hugging Face. Cada parámetro (contexto, concurrencia, partición de VRAM, cuantización, parsers) se eligió con base en evidencia, no en suposiciones.
Es esta combinación — experiencia de ingeniería más investigación y disciplina de laboratorio aplicadas a la IA — la que permite extraer de la GPU el mejor rendimiento con estabilidad y previsibilidad.
Ingeniería y operación
- LLM ajustado para producción: decodificación especulativa (MTP), tool-calling nativo para agentes de código, partición de VRAM (LLM + embeddings en la misma GPU) e historial de configuraciones mantenido como scripts, lo que permite cambios sin reimplementación.
- Operación madura: servicios bajo systemd con auto-restart, scripts de orquestación y health-check, runbooks y procedimiento de rollback.
- Dashboard de operaciones propio: estado, métricas históricas, control de start/stop y monitor de VRAM.
- Multi-tenant en la GPU: protocolo documentado para que el render 3D comparta y libere la GPU con el LLM — una sola GPU atendiendo inferencia, generación de medios y render al mismo tiempo.
- Estabilidad comprobada: 120 días en producción sin incidencias, con espejo redundante.
En resumen: una base de IA privada que convierte hardware dedicado en capacidad de inferencia escalable, soberana y de costo predecible para productos que exigen gobernanza de datos.